Le brouillon de votre chapitre,
en 5 minutes, en local.
Story Engine lit votre Story Bible, vos arcs narratifs et le synopsis du chapitre cible — puis génère 1500 mots de prose dans votre langue, avec la voix de votre persona. Anthropic Claude, Ollama, LM Studio. Votre choix.
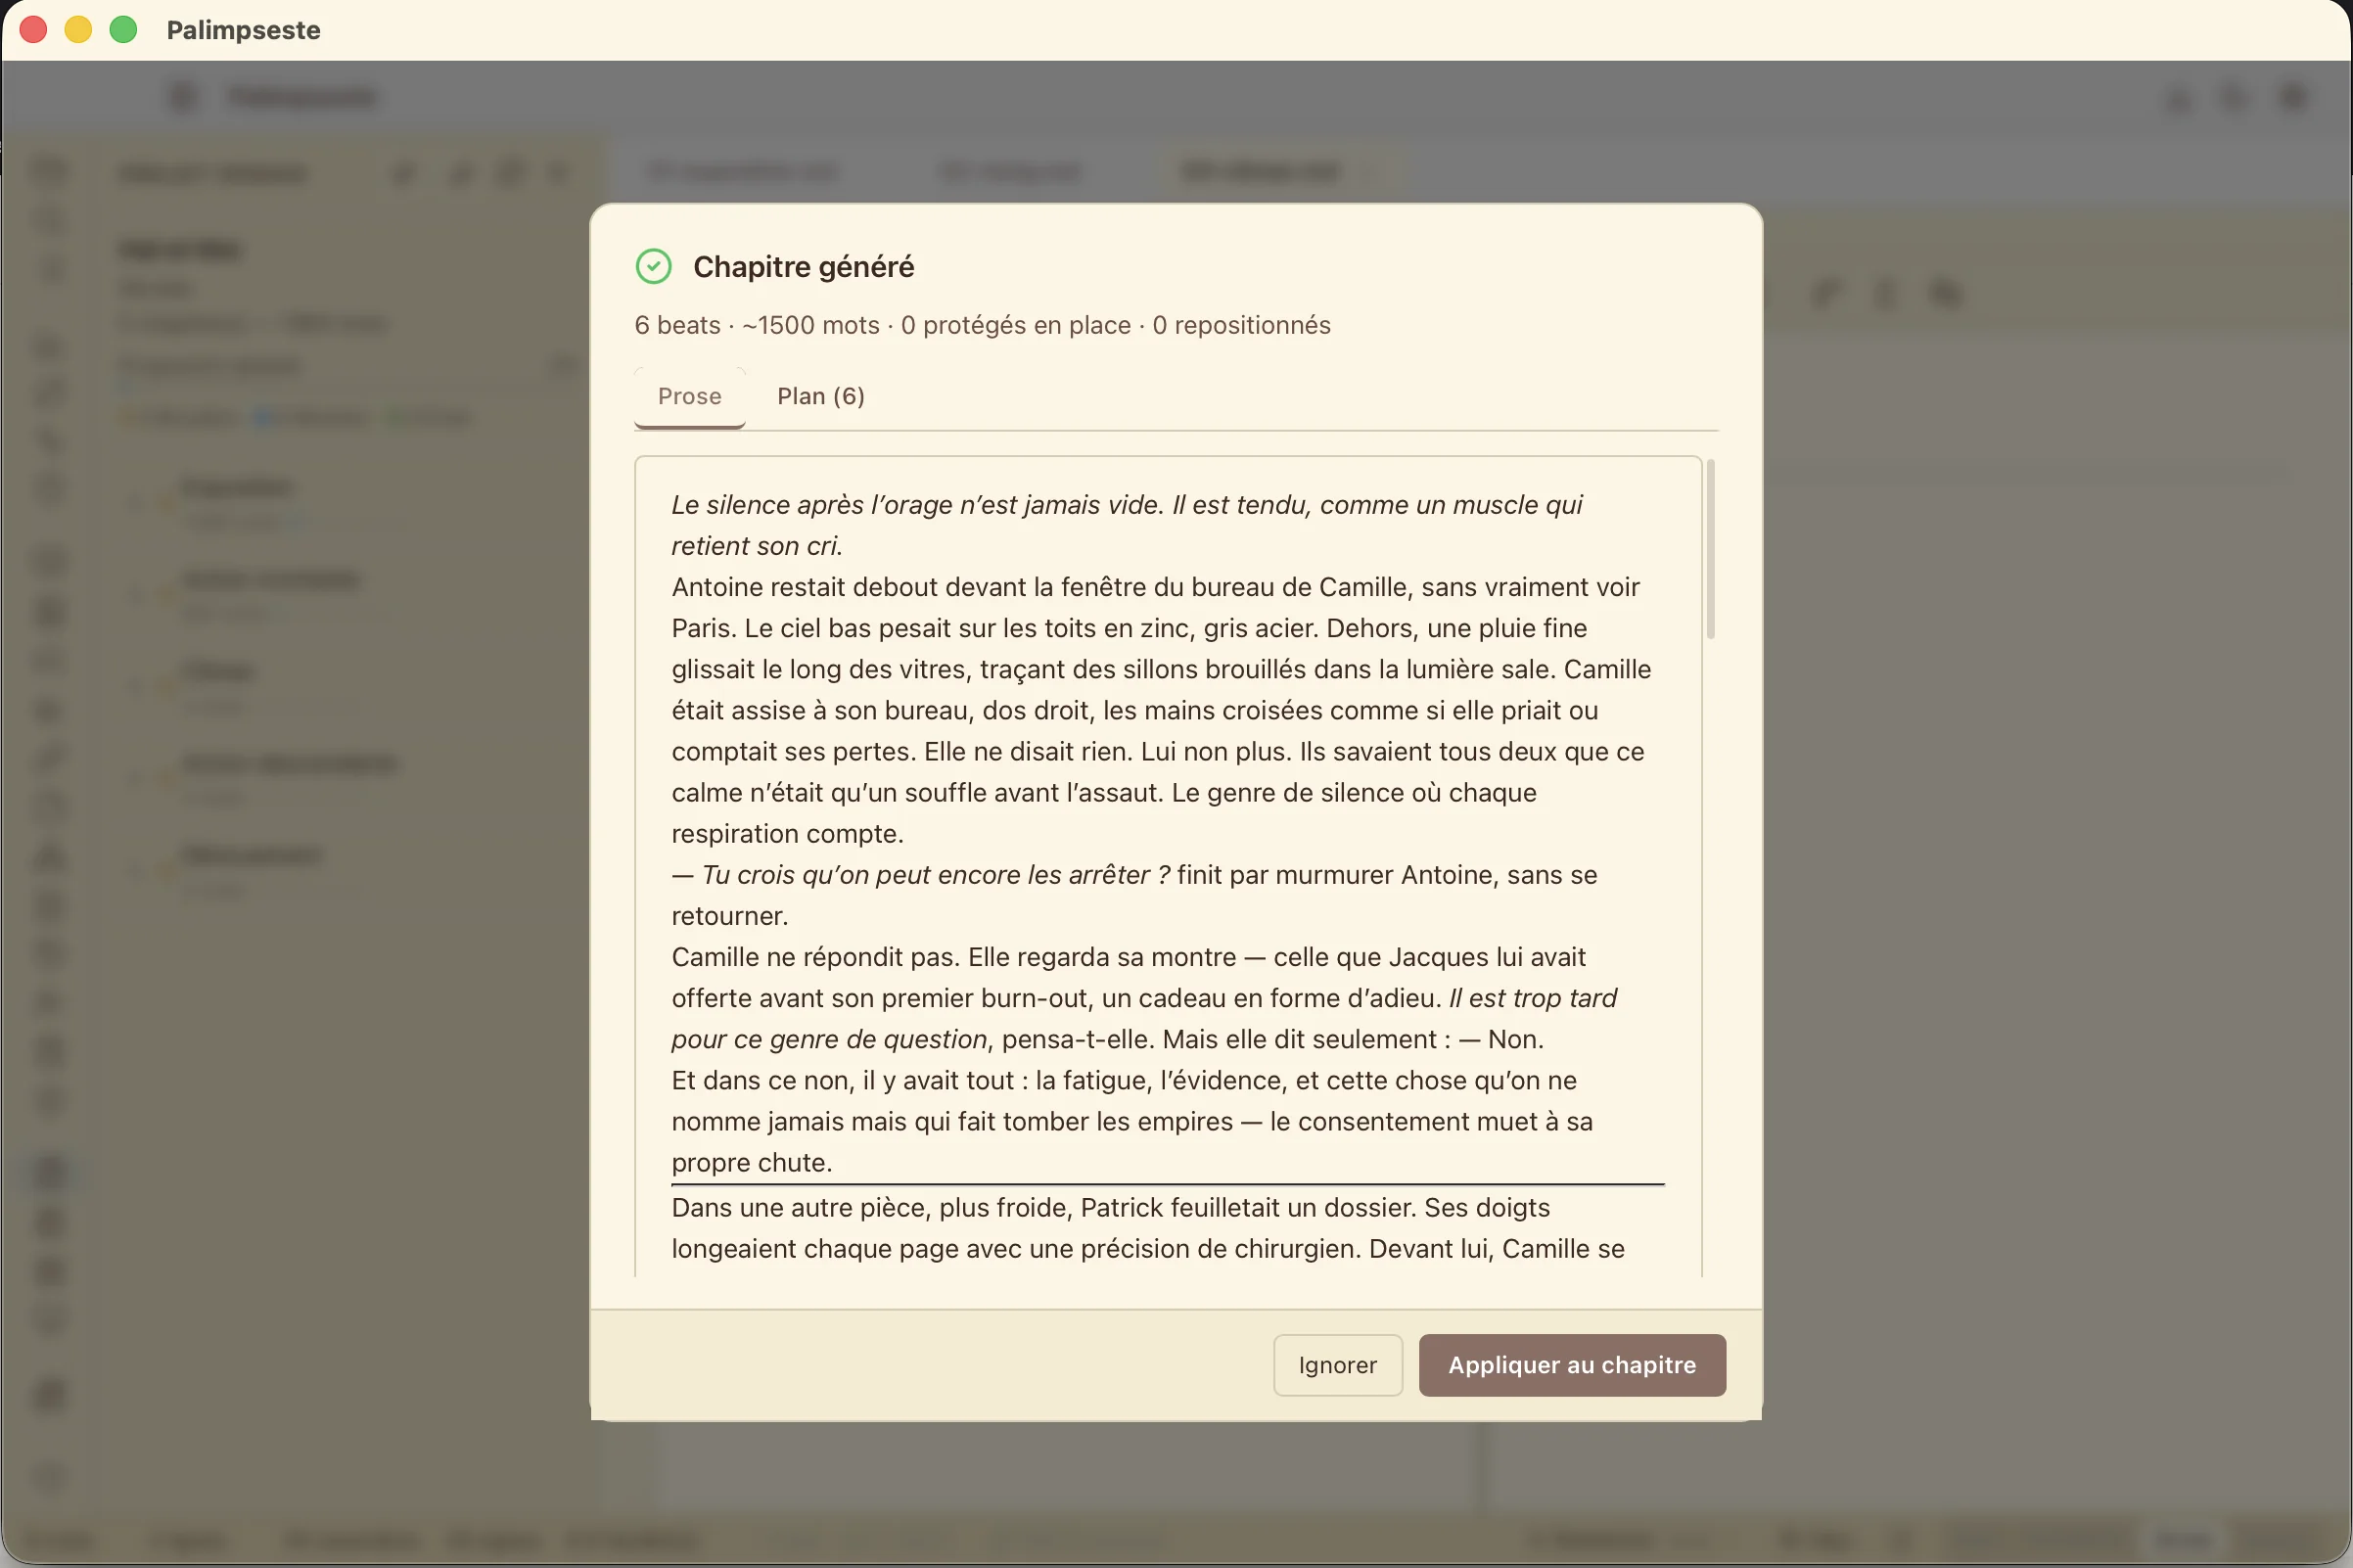
Un générateur de chapitre, pensé local-first
Tout ce dont vous avez besoin pour écrire un chapitre, sans dépendance cloud obligatoire ni format propriétaire. Et tout cela est inclus dans votre abonnement à 59,99 €/an TTC.
- ✓ Génération de chapitre complet — pipeline 2-passes (plan beat-by-beat puis prose markdown), environ 1500 mots par chapitre.
- ✓ 100 % local possible — vos manuscrits restent sur votre disque. Avec un modèle local (Ollama, LM Studio), aucun fragment ne quitte votre machine.
- ✓ Cloud quand vous le choisissez — Anthropic Claude, OpenAI GPT, via votre propre clé API. Aucune marge intermédiaire, aucun abonnement croisé.
- ✓ UI native en 5 langues — français, anglais, allemand, espagnol, italien. La langue de génération suit celle du projet.
- ✓ Story Bible + Plot Threads + Synopses intégrés — l'IA lit vos fiches personnages, vos arcs narratifs et le synopsis du chapitre avant d'écrire.
- ✓ Trois profils métier — romancier, chercheur, journaliste. Chacun ajuste le vocabulaire et la structure narrative.
- ✓ Formats ouverts uniquement — Markdown, YAML, JSON. Versionnables sous Git. Lisibles dans dix ans, dans n'importe quel éditeur.
Un pipeline en deux passes — pas de prose au hasard
Story Engine ne se contente pas de « générer du texte ». Il planifie d'abord la structure du chapitre (qui parle, où, pourquoi, combien de mots), puis écrit ensuite la prose en respectant ce plan. Vous validez le plan avant la rédaction, et vous voyez les deux à l'application.

<!-- locked -->, génération complète redémarre du blanc), vérification du LLM et budget de sortie.
Plan beat-by-beat

3 à 8 beats par chapitre — chacun avec son rôle (ouverture, climax, résolution…), ses participants, son lieu, son intention dramatique et son budget de mots. JSON structuré, validé par schéma.
Prose markdown

~1500 mots de prose en un seul appel — pas beat par beat, pour préserver la cohérence interne entre les scènes. Style guide du persona injecté en tête de prompt, vocabulaire glossaire respecté.
Préservation atomique

Vos passages encadrés par <!-- locked --> ... <!-- /locked --> survivent verbatim. Les ancres de section IDs (<!-- id: sec-XXX -->) sont aussi auto-protégées. Backup .bak avant écriture, hot-swap du buffer ouvert.
Trois profils métier — même moteur, vocabulaire adapté
📖 Romancier
Beats : opening · rising · midpoint · climax · resolution · transition
Prose narrative, dialogues vivants, sensorialité. Show don't tell. Phrases courtes pour la tension, plus longues pour la réflexion.
🎓 Chercheur
Beats : premise · evidence · counter-argument · synthesis · implication
Prose argumentative. Connecteurs logiques explicites (« par conséquent », « néanmoins »). Citations des sources fournies. Une thèse par paragraphe.
📰 Journaliste
Beats : lede · context · development · interview-quote · conclusion
Prose journalistique. Lead avec le scoop, pas le contexte. Voix active. Attribution systématique (« selon X »). Paragraphes courts.
Pour ceux qui veulent comprendre
Modèles supportés
- Anthropic Claude Sonnet 4.6+, Opus, Haiku
- OpenAI GPT-4.1, GPT-4o, o3, o4
- Ollama Qwen 2.5 32B (recommandé), Gemma 3 27B, Llama 3.3 70B, Mistral Small 3, Phi-4 14B
- LM Studio tout modèle compatible OpenAI API
Chaîne résiliente (Sprint H)
Quand un modèle local refuse de produire du JSON valide (panic chain-of-thought, fences markdown, channels MoE), Palimpseste enchaîne 4 stratégies automatiquement :
native → cooldown → stripped → cloud fallback (opt-in implicite).
Budget contexte
Pre-flight dialog affichant input + sortie estimée vs fenêtre du modèle. Bandeau rouge « Budget tendu » dès que l'utilisation dépasse 70 % du contexte. Persona-docs et bible filtrés par chapitre cible pour rester sous le budget.
Continuité cross-chapter
Les synopses des chapitres précédent et suivant (cap 200 caractères chacun) sont injectés dans le prompt — l'IA évite de re-raconter et peut préfigurer la suite, sans exploser le budget tokens.

Prêt à essayer ?
Téléchargez Palimpseste gratuitement. Story Engine est inclus dans l'offre Pro (à partir de 6,99 € TTC/mois).